파이프라인·입출력·오류 검출
한마디로명령어는 겹쳐 처리하고, 입출력은 담당자를, 오류는 검출과 정정을 구별해요.
3D 해설 영상
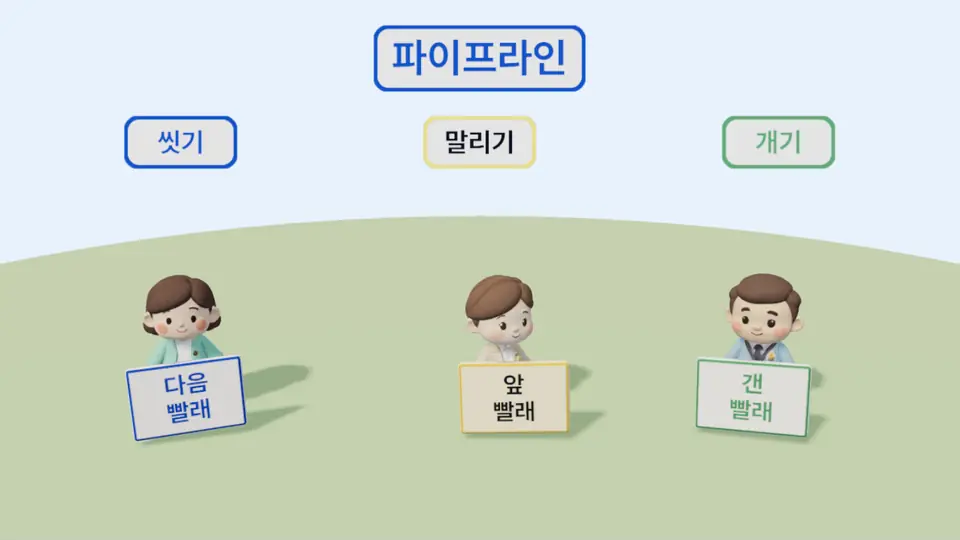
앞 빨래를 말리면서 다음 빨래를 씻어요. 파이프라인도 여러 명령어의 서로 다른 단계를 겹쳐 처리해요.
직접 해 보기
명령어를 겹쳐 처리하기
첫 빨래를 건조하는 동안 두 번째 빨래를 씻고, 먼저 마른 빨래를 개요. 서로 다른 일을 동시에 진행하니 여러 묶음을 더 빨리 끝낼 수 있어요. 파이프라인도 여러 명령어의 서로 다른 단계를 겹쳐 진행해요.
이 예에서는 5단계를 써요. IF는 명령어 가져오기, ID는 해석과 레지스터 읽기예요. EX는 계산, MEM은 데이터 메모리 접근, WB는 결과를 레지스터에 쓰기예요. 레지스터는 CPU 안의 작은 저장 공간이에요.
첫 덧셈이 만든 R1을 바로 뒤 뺄셈이 읽어요. 포워딩을 껐다 켜며 대기를 비교하세요.
R1·R2 같은 이름은 레지스터예요. ←는 오른쪽 값을 왼쪽에 넣는다는 뜻이에요. 메모리[R2]는 R2가 가리키는 주소의 값이에요.
올바른 경로의 명령어 2개를 끝내는 시간
6사이클
지연이 없으면 5 + 2 − 1 = 6사이클이에요. 지금은 여기에 0사이클이 더 들어요.
겹쳐 처리하지 않으면 2 × 5 = 10사이클이에요. 이 모형의 현재 속도 향상은 10 ÷ 6 ≈ 1.67배예요.
가로는 사이클, 세로는 명령어예요
스톨은 진행을 잠시 멈추는 것이에요. ID 대기는 그 단계에 머무른다는 뜻이에요. 버블은 실제 명령어가 일을 하지 않는 빈 단계예요. 아래 마지막 행은 EX 단계에 버블이 들어간 사이클만 표시해요.
| 명령어 | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| R1 ← R2 + R3 | IF | ID | EX | MEM | WB | — |
| R4 ← R1 − R5 | — | IF | ID | EX | MEM | WB |
| EX의 빈칸 | — | — | — | — | — | — |
계산에 쓰는 규칙
- 각 단계는 같은 1사이클이에요. 한 사이클에 새 명령어는 최대 하나 들어와요. 명령어·데이터 메모리는 분리하고 다른 지연은 없다고 가정해요.
- WB 사이클의 앞 절반에 레지스터를 쓰고 ID의 뒤 절반에 읽어요. 포워딩이 없으면 의존 명령어의 ID 완료는 앞 명령어의 WB와 같은 사이클이거나 그 뒤예요.
- 포워딩이 있으면 ALU(산술·논리 연산 장치)의 결과를 다음 명령어의 EX로 바로 전달해요. 적재 결과는 MEM이 끝난 뒤에 나와서, 바로 사용하는 명령어에는 1사이클 스톨이 남아요.
- 분기는 EX 끝에 결정해요. 예측 실패 때 뒤의 2개를 비우고 다음 사이클부터 올바른 경로를 가져와요. 예측 성공 때는 분기 다음 사이클부터 올바른 경로를 가져온다고 가정해요.
- 모든 명령어를 5단계 틀에 놓아요. ALU 명령어의 MEM이나 분기의 WB처럼 할 일이 없는 단계는 그냥 지나가요.
- 속도 비교에서는 두 방식의 사이클 시간이 같고, 파이프라인 관리에 드는 추가 시간은 없다고 가정해요. 단계의 수와 이름은 설계나 설명 방식에 따라 달라질 수 있어요.
이상적인 속도 향상은 nk ÷ (k + n − 1)이에요. k는 단계 수, n은 명령어 수예요. 위의 이상적인 조건에서 n이 커지면 k배에 가까워져요. 명령어 하나의 처리 시간이 곧바로 k분의 1이 된다는 뜻은 아니에요.
- 구조적 해저드 · 같은 자원을 함께 요구해요
- IF와 MEM이 같은 단일 포트 메모리를 동시에 쓰려 하면 충돌해요. 자원을 늘리거나 명령어·데이터 메모리를 분리해 해결할 수 있어요.
- 데이터 해저드 · 앞에서 만들 값을 뒤에서 읽어요
- 위의 R1 의존은 RAW(쓰기 뒤 읽기) 관계예요. 스톨로 기다리거나 포워딩으로 값을 바로 전달해요. 컴파일러가 결과를 바꾸지 않는 범위에서 독립적인 명령어를 사이에 넣어 대기를 줄이기도 해요.
- 제어 해저드 · 다음에 갈 곳이 아직 확정되지 않았어요
- 분기 결과가 나오기 전에 다음 명령어를 가져와서 생겨요. 정적 예측은 미리 정한 규칙을, 동적 예측은 실행 이력 등을 이용해요. 틀린 경로의 명령어를 버리는 것을 플러시라고 해요. 지연 분기는 분기 뒤의 정해진 지연 슬롯에 실행해도 되는 명령어를 배치하는 방식이에요.
슈퍼스칼라: 여러 실행 파이프라인에 한 사이클에 여러 명령어를 발행해요.
슈퍼파이프라인: 단계를 더 잘게 나눠 더 짧은 사이클 시간을 노려요.
VLIW(매우 긴 명령어): 컴파일러가 함께 실행할 연산들을 하나의 긴 명령어로 묶어요.
비트를 뒤집고 오류 위치 찾기
데이터 1011에 검사 비트 3개를 더해 보내요. 아래에서 5번 비트를 뒤집어 보세요. 세 검사 결과를 합치면 5가 나와서 그 자리를 고칠 수 있어요.
(7,4)는 전체 7비트 중 데이터가 4비트라는 뜻이에요. 이 예제는 짝수 패리티를 쓰는 단일 오류 정정 해밍 코드예요. 추가 전체 패리티 비트는 붙이지 않아요.
| 위치 | 1P1 | 2P2 | 3D1 | 4P4 | 5D2 | 6D3 | 7D4 |
|---|---|---|---|---|---|---|---|
| 전송 | 0 | 1 | 1 | 0 | 0 | 1 | 1 |
| 수신 | 0 | 1 | 1 | 0 | 0 | 1 | 1 |
| 정정 후보 | 0 | 1 | 1 | 0 | 0 | 1 | 1 |
패리티를 만들고, 같은 묶음으로 검사해요
P는 패리티 비트, D는 데이터 비트예요. ⊕는 XOR(두 비트가 다르면 1, 같으면 0)이에요. 여러 비트를 XOR하면 1의 개수가 짝수일 때 0이 나와요. S는 수신한 비트의 검사 결과예요.
- P1가 맡는 위치: 1 · 3 · 5 · 7
- 만들 때 P1 = D1 ⊕ D2 ⊕ D4 = 1 ⊕ 0 ⊕ 1 = 0
- 수신 검사 S1 = 0 ⊕ 1 ⊕ 0 ⊕ 1 = 0 · 짝수 패리티를 만족해요.
- P2가 맡는 위치: 2 · 3 · 6 · 7
- 만들 때 P2 = D1 ⊕ D3 ⊕ D4 = 1 ⊕ 1 ⊕ 1 = 1
- 수신 검사 S2 = 1 ⊕ 1 ⊕ 1 ⊕ 1 = 0 · 짝수 패리티를 만족해요.
- P4가 맡는 위치: 4 · 5 · 6 · 7
- 만들 때 P4 = D2 ⊕ D3 ⊕ D4 = 0 ⊕ 1 ⊕ 1 = 0
- 수신 검사 S4 = 0 ⊕ 0 ⊕ 1 ⊕ 1 = 0 · 짝수 패리티를 만족해요.
신드롬 · 검사 결과를 합친 값
S4S2S1 = 000₂ = 4 × 0 + 2 × 0 + 1 × 0 = 0
검사 결과가 모두 0이므로 정정하지 않아요.
정정 후보: 0110011
후보에서 꺼낸 데이터: 1011 · 처음 데이터: 1011
이 실험에서는 뒤집은 비트가 없고 원본과 같아요.
화면은 사용자가 뒤집은 위치를 알고 있어서 원본과 비교할 수 있어요. 실제 수신기는 그 위치나 오류 개수를 미리 알지 못해요. 신드롬이 오류 위치가 되는 것은 단일 오류일 때예요.
2비트를 뒤집으면 바르게 고칠 수 없어요. 이 (7,4) 코드는 신드롬만으로 1비트 오류와 2비트 오류를 구별하지 못해요. 2비트 오류에 단일 오류 정정을 적용하면 잘못된 코드워드가 나와요.
데이터가 늘면 패리티는 몇 비트일까요?
검사 결과는 오류가 없는 경우와, 전체 m + p개 위치 각각의 오류를 구별해야 해요. 따라서 2^p ≥ m + p + 1을 만족하는 가장 작은 정수 p를 찾아요.
패리티 3비트 · 전체 7비트
p = 2: 2^2 = 4 < 4 + 2 + 1 = 7이라 부족해요.
p = 3: 2^3 = 8 ≥ 4 + 3 + 1 = 8이라 충분해요.
- 단일 패리티 · 홀짝으로 검사해요
- 1011에는 1이 3개 있어요. 짝수 패리티 비트는 1, 홀수 패리티 비트는 0을 붙여요. 단일 패리티는 홀수 개의 비트 오류를 검출하지만 위치는 몰라요. 2개처럼 짝수 개가 뒤집히면 놓쳐요.
- CRC(순환 중복 검사) · 나머지로 검사해요
- 생성 다항식의 차수만큼 데이터 뒤에 0을 붙여 XOR 나눗셈을 해요. 얻은 나머지를 원래 데이터 뒤에 붙여 보내요. 수신 쪽도 같은 생성 다항식으로 나눠 검사해요. 오류 검출용이며, 연속된 구간의 오류인 버스트 오류 검출에 강해요.
- 체크섬 · 합으로 검사해요
- 덧셈식 체크섬은 데이터를 정해진 단위로 더해 검사값을 만들어요. 수신 쪽에서 다시 계산해 확인해요. 덧셈이나 보수를 취하는 구체적인 방법은 규약에 따라 달라요.
- FEC는 수신 쪽 정정, BEC는 재전송
- FEC(전진 오류 수정)는 해밍 코드처럼 여분 비트로 수신 쪽에서 오류를 고쳐요. BEC(후진 오류 수정)는 ARQ(자동 재전송 요구)처럼 재전송을 이용해요.
4KB를 옮길 때 누가 일할까요?
장치에서 주기억장치로 데이터를 읽어 와요. 이 예제의 4KB는 4,096바이트인 4KiB로 정해요. 전송 단위가 4바이트이므로 모두 1024개 단위를 옮겨요. I/O는 입력과 출력을 뜻해요.
프로그램 I/O의 진행 순서
- CPU · 장치에 읽기 명령을 내리고 상태 레지스터를 확인해요.
- CPU · 준비되지 않았으면 다시 확인해요. 이 예에서는 이 반복 확인 동안 다른 작업을 하지 않아요.
- CPU · 준비되면 장치에서 4바이트를 읽어 주기억장치에 써요.
- CPU · 주소와 남은 양을 바꾸며 반복해요. 모두 1024개 전송 단위를 직접 옮겨요.
CPU가 직접 옮기는 데이터: 1024단위
DMA 제어기가 옮기는 데이터: 0단위 · 이 전송을 위한 인터럽트: 0회
이 예에서는 준비 확인을 반복하는 동안에도 CPU를 붙잡아 두어요.
횟수 계산의 조건이에요. 인터럽트 I/O는 4바이트가 준비될 때마다 한 번 알리도록 정했어요. DMA는 오류 없이 블록을 전송한 뒤 한 번 알리도록 정했어요. 실제 장치의 버퍼와 알림 방식에 따라 인터럽트 횟수는 달라져요. 프로그램 I/O의 상태 확인 횟수나 실제 전송 시간은 따로 계산하지 않아요.
사이클 스틸링은 버스를 한 사이클씩 빌리는 방식이에요. DMA 제어기가 버스를 쓰는 동안 같은 버스가 필요한 CPU는 기다릴 수 있어요. DMA가 CPU를 전송 과정에서 완전히 없앤다는 뜻은 아니에요.
사례에서 전송 담당자를 찾아요
준비 상태를 누가 확인하는지 먼저 보세요. 그다음 실제 데이터를 누가 옮기는지 확인하세요.
1. CPU가 장치의 준비 표시를 반복해서 읽다가, 준비되면 데이터를 직접 메모리에 써요.
2. 장치의 준비 알림을 받은 CPU가 처리 코드에서 장치 데이터를 읽어 메모리에 써요.
3. CPU가 주소와 길이를 설정한 뒤, 별도 제어기가 버스를 빌려 장치와 메모리 사이의 블록을 옮겨요.
4. 별도 제어기가 블록을 모두 옮긴 뒤 완료 인터럽트를 보내고, CPU는 완료 상태만 확인해요.
채널은 입출력 전용 프로세서예요
DMA가 설정된 전송을 맡는다면, 채널은 채널 프로그램의 명령들을 실행하며 입출력을 관리해요. 여러 장치를 어떤 단위로 나누어 처리하는지 구별해요.
- 셀렉터 채널
- 한 번에 한 장치를 골라 집중해서 전송해요.
- 멀티플렉서 채널 · 바이트 멀티플렉서
- 여러 저속 장치의 데이터를 바이트 같은 작은 단위로 번갈아 처리해요.
- 블록 멀티플렉서 채널
- 여러 장치의 블록 전송을 번갈아 처리해요.
데이지 체인에서 먼저 처리할 요청 찾기
장치 나와 장치 라가 동시에 요청했어요. CPU에서 나온 승인 신호는 장치 가부터 연결 순서대로 지나가요. 요청하지 않은 장치 가를 지나, 요청 중인 장치 나가 먼저 승인을 받아요.
모든 요청은 허용되어 있고 동시에 대기한다고 가정해요. 우선순위는 승인 신호의 연결 순서로 정해요. 장치의 종류나 실제로 떨어진 거리는 따지지 않아요.
현재 승인 신호가 지나는 순서
CPU → 장치 가 → 장치 나 → 장치 다 → 장치 라
먼저 처리할 장치: 장치 나
요청 중인 장치 가운데 장치 나에 승인 신호가 먼저 도달해요. 이 장치가 승인을 받으면 뒤의 요청 장치들은 기다려요.
첫 요청 처리는 해당 장치의 요청 표시를 지워요. 새 요청은 자동으로 생기지 않아요. 앞뒤 순서를 바꾸면 같은 요청 묶음에서도 첫 장치가 달라질 수 있어요.
- 소프트웨어 폴링 · CPU가 차례로 물어요
- CPU가 장치의 요청 여부를 정해진 순서로 확인해요. 프로그램에서 확인 순서를 바꾸기 쉬워 유연해요. 장치를 차례로 확인하는 시간이 들어요.
- 데이지 체인 · 승인 신호를 직렬로 전달해요
- 하드웨어 연결 순서로 우선순위를 정해요. 요청 중인 장치 가운데 CPU 쪽에서 승인 신호를 먼저 받는 장치가 우선해요.
- 병렬 우선순위 · 여러 요청을 함께 받아 골라요
- 장치별 요청 선으로 들어온 요청을 우선순위 인코더가 골라요. 인코더는 허용된 요청 중 우선순위가 높은 것을 코드로 나타내는 회로예요. 마스크 레지스터는 어떤 요청을 허용하거나 막을지 정해요.
이어서 연결해요
- 명령어 형식·주소 지정·메모리 종류는 컴퓨터 구조에서 확인해요.
- 인터럽트의 종류와 처리 순서는 프로세스 상태에서 연결해요.
- 여러 디스크의 고장에 대비하는 패리티는 메모리 배치와 디스크 관리의 RAID 설명에서 확인해요.
명령어 순서를 고르고 포워딩을 바꾸면 기다리는 사이클이 달라져요. 해밍 코드에서는 비트를 직접 뒤집어 오류 위치를 찾아보세요. 입출력 사례와 데이지 체인도 선택을 바꾸며 연습할 수 있어요.
핵심 정리
앞 빨래를 말리는 동안 다음 빨래를 해요
첫 빨래를 건조하는 동안 두 번째 빨래를 씻고, 먼저 마른 빨래는 갤 수 있어요. 파이프라인도 여러 명령어의 서로 다른 단계를 겹쳐 처리해요. 각 단계가 1사이클이고 지연이 없다면, k단계에서 n개 명령어를 끝내는 데 k + n − 1사이클이 걸려요. 겹쳐 처리하지 않으면 n × k사이클이 필요해요.
자원·결과·갈 길 때문에 기다려요
덧셈 결과가 아직 없는데 다음 뺄셈이 그 값을 쓰려 하면 기다려야 할 수 있어요. 이렇게 파이프라인 진행을 막는 상황을 해저드라고 해요. 구조적 해저드는 자원 충돌, 데이터 해저드는 필요한 값의 의존 관계, 제어 해저드는 분기 때문에 생겨요. 자원을 늘리거나, 결과를 바로 전달하거나, 다음 실행 경로를 예측하는 등 원인에 맞게 대응해요.
준비됐다는 알림과 데이터 이동은 달라요
장치가 준비됐다고 알려줘도 CPU가 데이터를 직접 옮겨야 할 수 있어요. 프로그램 I/O는 CPU가 준비 상태를 반복 확인하고 데이터를 옮겨요. 인터럽트 I/O는 장치가 CPU에 알리지만 데이터 이동은 여전히 CPU가 맡아요. DMA는 CPU가 전송 정보를 설정하면 DMA 제어기가 장치와 주기억장치 사이의 데이터를 옮기고, 보통 완료 인터럽트로 알려요.
동시에 요청하면 정해진 우선순위로 골라요
CPU·장치 가·장치 나 순서의 데이지 체인에서 두 장치가 함께 요청하면 장치 가가 먼저예요. 데이지 체인은 승인 신호가 지나는 연결 순서로 우선순위를 정해요. 소프트웨어 폴링은 CPU가 장치를 차례로 확인하므로 순서를 바꾸기 쉽지만 확인 시간이 들어요. 병렬 우선순위는 장치별 요청 선과 우선순위 인코더를 쓰고, 마스크로 요청의 허용 여부를 정해요.
틀렸다는 것과 어디가 틀렸는지는 달라요
데이터의 한 비트가 뒤집히면 단일 패리티 검사로 이상을 알 수 있지만 위치는 몰라요. 짝수 패리티는 패리티 비트까지 포함한 1의 개수를 짝수로, 홀수 패리티는 홀수로 맞춰요. 단일 패리티는 2비트 오류를 놓쳐요. 해밍 코드는 여러 패리티 검사를 조합해 1비트 오류의 위치를 찾아 고쳐요.
검사값으로 확인하거나 다시 보내 달라고 해요
보낸 데이터와 받은 데이터의 검사값이 맞지 않으면 오류를 알아차릴 수 있어요. CRC는 생성 다항식으로 나눈 나머지를 이용하는 오류 검출 방식이며, 연속된 구간의 오류인 버스트 오류 검출에 강해요. 덧셈식 체크섬은 데이터를 정해진 단위로 더해 검사값을 만들어요. 수신 쪽에서 여분 비트로 고치는 FEC와, 오류 검출 뒤 재전송을 이용하는 BEC를 구별해요.
이렇게 외워요
구조는 자원, 데이터는 값, 제어는 길
같은 자원을 함께 쓰려 하면 구조적 해저드예요. 앞의 값이 필요하면 데이터 해저드, 분기 뒤 갈 길이 문제면 제어 해저드예요.
폴링은 확인, 인터럽트는 알림, DMA는 전송
프로그램 I/O와 인터럽트 I/O에서는 CPU가 데이터를 옮겨요. DMA에서는 DMA 제어기가 옮겨요. 완료 인터럽트가 있다는 이유만으로 인터럽트 I/O라고 고르면 안 돼요.
1·2·4·8은 패리티 자리
해밍 코드의 패리티 비트는 2의 거듭제곱 위치에 놓아요. 이 예제의 7비트는 P1·P2·D1·P4·D2·D3·D4 순서예요.
암기 카드
남은 카드 9장. ‘다시 볼래요’를 누르면 맨 뒤로 가요.
OX 퀴즈
- 1
각 단계가 1사이클이고 지연이 없는 k단계 파이프라인은 n개 명령어를 k + n − 1사이클에 처리한다.
- 2
단일 포트 메모리를 명령어 인출과 데이터 접근이 동시에 요구하면 구조적 해저드가 생길 수 있다.
- 3
고전적인 5단계 모형에서 포워딩을 쓰면 적재 직후 그 값을 사용하는 명령어도 항상 대기 없이 실행된다.
- 4
DMA에서도 CPU가 전송할 데이터의 모든 단위를 직접 읽고 써야 한다.
- 5
데이지 체인에서 동시에 요청한 장치 중 승인 신호를 먼저 받는 장치의 우선순위가 높다.
- 6
단일 짝수 패리티는 서로 다른 2비트가 뒤집힌 오류를 반드시 검출한다.
- 7
데이터 4비트의 단일 오류 정정용 해밍 코드에는 패리티 3비트가 필요하다.
- 8
CRC는 오류 위치를 찾아 해당 비트를 고치는 정정 방식이다.
컴퓨터일반 자료 전체의 카드와 OX를 한 번에 풀려면 컴퓨터일반 카드·OX 모아 풀기로 가요.
근거
- 표준 이론 참고 문헌: Patterson·Hennessy, Computer Organization and Design — 명령어 파이프라인, 구조적·데이터·제어 해저드, 포워딩과 적재 후 사용 지연
- 표준 이론 참고 문헌: Stallings, Computer Organization and Architecture — 프로그램 I/O, 인터럽트 I/O, DMA, 입출력 채널, 병렬 명령어 처리
- 표준 이론 참고 문헌: Mano, Computer System Architecture — 인터럽트 우선순위, 데이지 체인, 병렬 우선순위, 패리티와 해밍 코드
- 표준 오류 제어 개념: 단일 패리티, 이진 해밍 코드의 단일 오류 정정 조건, CRC의 다항식 나눗셈, 체크섬, FEC와 ARQ
- 2024년 계리직 컴퓨터일반에 나온 유형(인터럽트 우선순위). 이 페이지의 예제와 수치는 새로 만들었어요.
학습을 돕는 자료예요. 법령과 제도는 바뀔 수 있으니 시험 직전에는 공식 자료로 다시 확인하세요.
컴퓨터일반 다른 개념
- OSI 7계층 한 번에 끝내기3D로 쌓은 7개 층을 하나씩 눌러 보며 층마다 하는 일, 데이터 이름, 프로토콜, 장비를 익혀요.3D 해설 영상컴퓨터일반 · 3D 모델 · 계리직
- 기억장치 계층 구조층을 하나씩 눌러 보며 레지스터부터 보조기억장치까지 속도·용량·가격이 어떻게 달라지는지 익혀요.3D 해설 영상컴퓨터일반 · 3D 모델 · 계리직
- CPU 스케줄링 시뮬레이터프로세스마다 도착 시간과 실행 시간을 넣고 CPU를 줄 순서를 정하는 규칙(FCFS·SJF·SRT·RR·HRN)을 바꾸면, 누가 언제 CPU를 쓰는지 그린 간트 차트와 평균 대기 시간이 바로 나와요.3D 해설 영상컴퓨터일반 · 시뮬레이터 · 계리직
- 페이지 교체 알고리즘참조열(페이지를 부르는 순서)과 프레임 수(메모리 칸 수)를 넣고 FIFO·LRU·LFU·OPT 등을 고르면, 언제 페이지 부재가 나고 무엇을 왜 내보내는지 표로 한 칸씩 보여 줘요.3D 해설 영상컴퓨터일반 · 시뮬레이터 · 계리직
- 메모리 배치와 디스크 관리빈 메모리에 프로그램을 넣고, 주소를 바꾸고, 디스크의 이동 거리와 고장에 견디는 범위를 직접 계산해요.3D 해설 영상컴퓨터일반 · 주소 변환·디스크 스케줄링 · 계리직
- 운영체제 구조·시스템 호출·리눅스 권한파일 권한을 바꾸고, 커널에 일을 부탁하는 과정과 디스크에 파일을 놓는 방식을 직접 비교해요.3D 해설 영상컴퓨터일반 · 권한 계산기·시스템 호출 따라가기 · 계리직
- 접근통제·방화벽·전자봉투·백업등급에 맞는 접근을 고르고, 전자봉투를 조립하고, 통신 규칙과 백업 순서를 직접 확인해요.3D 해설 영상컴퓨터일반 · 등급 판정·방화벽 규칙·백업 복원 계산 · 계리직
- 코드 읽기: 파이썬·C·자바 출력 따라가기출력을 먼저 예상하고, 한 문장씩 실행하며 변수와 출력이 어떻게 바뀌는지 확인해요.3D 해설 영상컴퓨터일반 · 코드 따라가기·출력 예측 · 계리직
- 기초영어 어휘·관용 표현 덱영어 낱말은 비슷한 뜻끼리 묶고, 생활 표현은 대화에 넣어 보며 외워요.3D 해설 영상컴퓨터일반 · 어휘·관용 표현 덱·유의어 퀴즈 · 계리직
- 엑셀 셀 참조 복사 시뮬레이터D6에 수식 하나를 넣고 오른쪽·아래로 복사해 보면서, $를 어디에 붙여야 표 전체가 맞게 채워지는지 직접 찾아봐요.3D 해설 영상컴퓨터일반 · 복사 시뮬레이터 · 계리직
- 엑셀 함수 결과 실험실작은 표에 수식을 넣고 결과와 참조 셀을 확인하면서 자주 나오는 엑셀 함수를 익혀요.3D 해설 영상컴퓨터일반 · 미니 시트·결과 맞히기 · 계리직
- 정규화 단계 따라가기수강신청 표 하나를 1NF부터 BCNF까지 직접 나눠 보면서, 단계마다 무엇을 떼어 내고 어떤 문제가 사라지는지 확인해요.3D 해설 영상컴퓨터일반 · 단계별 풀이 · 계리직
- SQL 쿼리 실험실사원·부서 표에 SELECT 문을 한 절씩 붙여 보면서, 어떤 행이 걸러지고 어떻게 묶이는지, NULL과 조인이 결과를 어떻게 바꾸는지 눈으로 확인해요.3D 해설 영상컴퓨터일반 · 쿼리 실험실 · 계리직
- 데이터베이스 기초학생 표에서 키를 찾고, 표를 합치거나 부모 행을 바꾸면서 데이터베이스의 규칙을 확인해요.3D 해설 영상컴퓨터일반 · 키 판별기·관계대수 실험 · 계리직
- IPv4 서브네팅 계산기IP 주소와 프리픽스를 넣어 32비트가 네트워크와 호스트로 갈리는 모습과 네트워크·브로드캐스트 주소·호스트 수를 보고, 두 주소가 같은 서브넷인지와 몇 개로 나눌 수 있는지도 직접 따져 봐요.3D 해설 영상컴퓨터일반 · 서브넷 계산기 · 계리직
- 자료구조와 정렬스택·큐에 직접 넣고 꺼내 보고, 우리가 쓰는 식(중위식)을 연산자를 뒤에 쓰는 식(후위식)으로 바꾸고, 트리를 순서대로 돌아보고, 정렬이 회전마다 배열을 어떻게 바꾸는지 한 단계씩 확인해요.3D 해설 영상컴퓨터일반 · 자료구조 실험실 · 계리직
- 컴퓨터 구조: 수 표현·논리회로·명령어·메모리10진수를 2의 보수와 IEEE 754 비트로 바꿔 보고, 카르노 맵을 눌러 식을 줄이고, 같은 계산을 0·1·2·3-주소 명령어로 실행하고, 명령어가 값을 어디서 찾는지 따라가며, 상황에 맞는 메모리(SRAM·DRAM·플래시)를 골라 봐요.3D 해설 영상컴퓨터일반 · 수 표현·회로 실험실 · 계리직
- 프로세스·인터럽트·교착상태 실험실CPU 하나에 프로세스 여럿을 올려 상태가 바뀌는 모습을 보고, 한꺼번에 몰린 인터럽트를 차례로 처리하고, 교착상태를 만들었다 풀고, 은행원 알고리즘으로 안전한 순서를 직접 찾아봐요.3D 해설 영상컴퓨터일반 · 상태·교착 실험실 · 계리직
- 소프트웨어공학 실험실상황에 맞는 생명 주기 모형을 고르고, 경계값·커버리지·순환 복잡도로 테스트 케이스를 직접 만들고, 가상의 우체국 앱 기능을 세어 기능 점수까지 계산해 봐요.3D 해설 영상컴퓨터일반 · 테스트·FP 실험실 · 계리직
- 인공지능·머신러닝 기초여러 상황을 지도·비지도·강화학습으로 나눠 보고, 점을 찍어 k-NN과 k-평균을 돌려 보고, 스팸 필터의 기준값을 옮기며 정확도·정밀도·재현율·F1을 계산해 봐요.3D 해설 영상컴퓨터일반 · 학습·평가 실험실 · 계리직
- 트랜잭션과 동시성 제어·회복계좌 이체 두 건을 섞어 실행해 갱신 분실·오손 읽기·모순성을 직접 만들어 보고, 2PL을 켜면 누가 기다리는지, 장애가 나면 무엇을 REDO·UNDO하는지 확인해요.3D 해설 영상컴퓨터일반 · 스케줄·회복 실험실 · 계리직
- 인터넷 프로토콜: 메일·웹·DNS·TCP/UDP메일 한 통을 SMTP로 보내고 POP3·IMAP으로 받아 어디에 남는지 보고, DNS 질의·TCP 연결·DHCP와 ping을 한 단계씩 따라가고, 포트 번호와 IPv6 줄여 쓰기를 연습해요.3D 해설 영상컴퓨터일반 · 프로토콜 실험실 · 계리직
- 정보보안 핵심 실험실어떤 키로 잠가야 하는지 골라 보고, 해시·전자서명·블록 사슬을 일부러 깨뜨려 보고, 공격 사례와 ISMS-P 의무 대상, 침입탐지·클라우드 책임까지 직접 판정해 봐요.3D 해설 영상컴퓨터일반 · 보안 실험실 · 계리직
- 클라우드와 신기술 실험실서비스 책임 범위를 직접 칠하고, 블록을 고쳐 해시 연결을 깨 보고, IoT·빅데이터·엣지 개념을 사례로 골라 봐요.3D 해설 영상컴퓨터일반 · 누가 관리할까?·블록체인 실험 · 계리직
- 계리직 기초영어 핵심우체국·은행·전화 장면의 대화 빈칸을 채우고, 밑줄 친 곳이 맞는지 틀린지 가리고, 자주 나오는 어휘와 독해 유형별 푸는 순서를 직접 풀면서 익혀요.3D 해설 영상컴퓨터일반 · 기초영어 연습 · 계리직